연구계획서를 내려는데 지도교수가 “표본 수 근거는요?”라고 묻습니다. IRB 심의서에도 표본 크기 산출 근거를 적는 칸이 있습니다. “선행연구가 200명이어서 200명으로 했다”는 답은 통하지 않습니다. 필요한 것은 검정력 분석(power analysis)이고, 그 계산을 무료로 해 주는 프로그램이 G*Power입니다.
이 글은 G*Power를 처음 켜는 사람이 30분 안에 자기 연구의 표본 수를 뽑고, 그 숫자를 연구방법 절의 한 문단으로 옮기는 데까지 가는 튜토리얼입니다. 검정별 설정값, 탈락률 보정, 그리고 “사후 검정력”이 왜 심사에서 문제가 되는지까지 다룹니다. 표본을 ‘몇 명’이 아니라 ‘누구로’ 뽑을지의 문제는 표본 추출 방법과 확률·비확률 표집에서 따로 다루니, 두 글을 같이 보면 표본 관련 서술이 통째로 정리됩니다.
검정력 분석은 네 값의 관계식이다
이해해야 할 구조는 단 하나입니다. 아래 네 값은 서로 묶여 있어서, 셋을 정하면 나머지 하나가 자동으로 결정됩니다.
- 유의수준 α — 실제로는 차이가 없는데 있다고 잘못 판정할 확률(1종 오류). 관례는 .05입니다.
- 검정력 1−β — 실제로 차이가 있을 때 그것을 잡아낼 확률. Cohen이 제안한 관례가 .80이고, 최근에는 .90을 쓰는 분야도 늘고 있습니다.
- 효과크기 — 찾아내고 싶은 차이나 관계의 크기. 검정마다 지표가 다릅니다.
- 표본 크기 N — 우리가 구하려는 값.
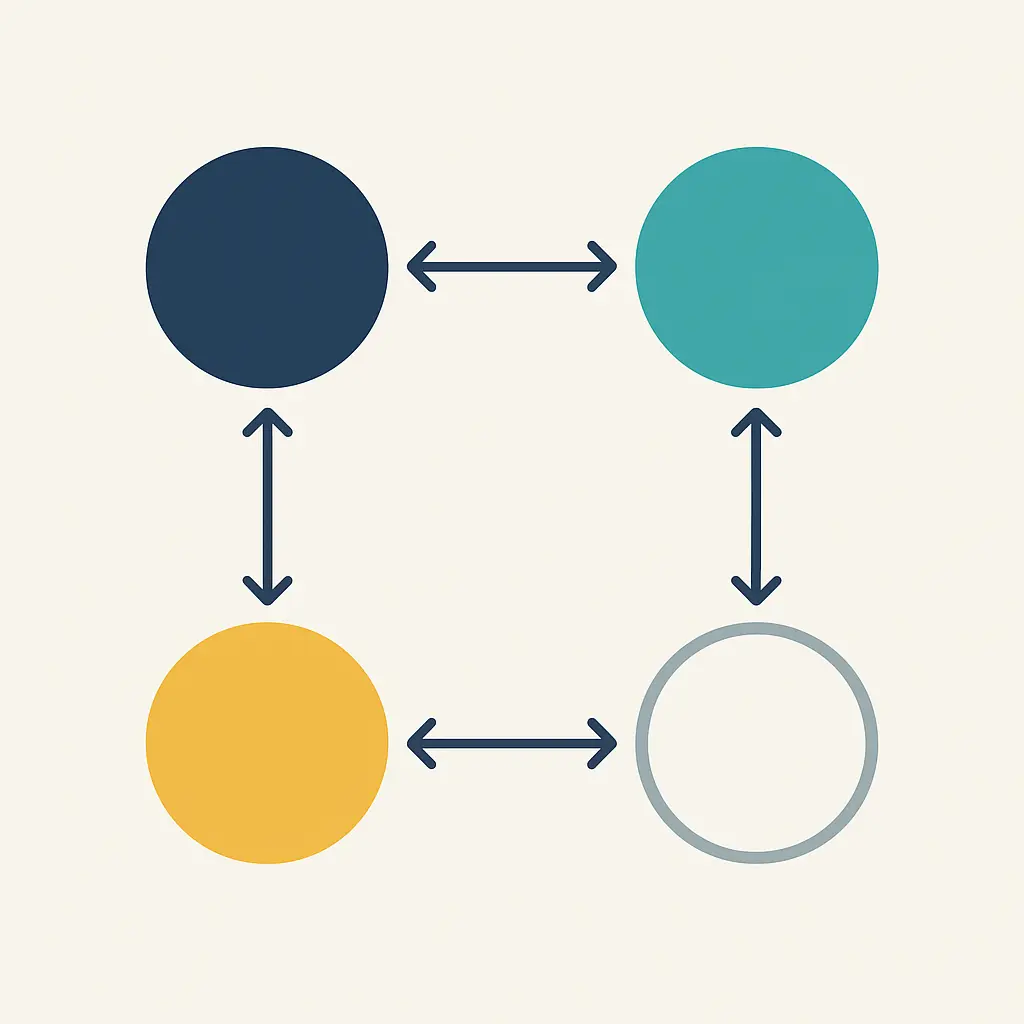
직관적으로도 맞습니다. 찾으려는 차이가 작을수록(효과크기 작음), 더 확실히 잡고 싶을수록(검정력 높음), 더 엄격하게 판정할수록(α 작음) 사람이 많이 필요합니다.
1단계 — G*Power 설치와 화면 구조
G*Power는 뒤셀도르프대학교에서 배포하는 무료 프로그램이며 윈도우와 macOS 모두 지원합니다. ‘G*Power’로 검색해 대학 배포 페이지에서 내려받아 설치하면 됩니다. 설치 후 화면 위쪽에 있는 세 개의 선택 상자가 전부입니다.
- Test family — 검정 계열. t tests, F tests, χ² tests, z tests, Exact 중에서 고릅니다.
- Statistical test — 구체적인 검정. 위에서 고른 계열에 따라 목록이 바뀝니다.
- Type of power analysis — 무엇을 구할 것인가. 네 가지가 있는데, 연구 전이라면 무조건 <A priori>입니다.
Type of power analysis 네 가지의 뜻을 짚어 두겠습니다.
- A priori — α·검정력·효과크기를 넣고 필요한 표본 수를 구합니다. 연구계획서와 IRB에 쓰는 것이 이것입니다.
- Post hoc — 이미 모은 자료로 사후 검정력을 구합니다. 뒤에서 설명하겠지만 논문에 싣기에는 문제가 있습니다.
- Sensitivity — 표본 수가 이미 정해져 있을 때 탐지할 수 있는 최소 효과크기를 구합니다. 자료를 다 모은 뒤 쓰기에 훨씬 나은 선택입니다.
- Criterion — 실무에서 거의 쓰지 않습니다.
2단계 — 효과크기를 어디서 가져올 것인가
여기가 검정력 분석에서 유일하게 판단이 필요한 지점입니다. 우선순위는 명확합니다.
- 같은 변수·같은 집단을 다룬 선행연구의 효과크기를 쓰는 것이 가장 좋습니다. 논문에 d나 η²가 보고되어 있으면 그대로 가져옵니다.
- 선행연구가 효과크기를 보고하지 않았다면 보고된 평균과 표준편차로 직접 계산합니다. G*Power의 <Determine> 버튼을 누르면 평균과 표준편차를 넣어 d를 산출하는 보조 창이 열립니다.
- 메타분석이 있다면 그 평균 효과크기가 가장 든든한 근거입니다.
- 아무 근거도 없을 때만 Cohen의 관례적 중간 효과크기를 씁니다. 이때는 “선행연구가 부족하여 중간 효과크기를 가정하였다”고 논문에 명시합니다.
검정별 효과크기 지표와 Cohen의 관례적 기준은 다음과 같습니다. 지표가 다르므로 t-검정의 d를 분산분석 칸에 넣는 실수를 조심해야 합니다.
| 검정 | 지표 | 작음 | 중간 | 큼 |
|---|---|---|---|---|
| 독립표본·대응표본 t-검정 | d | 0.20 | 0.50 | 0.80 |
| 분산분석(F 검정) | f | 0.10 | 0.25 | 0.40 |
| 다중회귀분석 | f² | 0.02 | 0.15 | 0.35 |
| 상관분석 | r | .10 | .30 | .50 |
| 카이제곱 검정 | w | 0.10 | 0.30 | 0.50 |
주의할 점이 하나 있습니다. 선행연구에서 유난히 큰 효과크기를 골라 넣으면 필요한 표본이 확 줄어듭니다. 계산은 편해지지만, 그 큰 효과가 실제로는 표본이 작은 연구에서 우연히 크게 나온 값일 가능성이 있습니다. 여러 편의 값을 모아 평균을 내거나, 가장 보수적인(작은) 효과크기를 채택하는 편이 나중에 “표본이 부족해 유의하지 않았다”는 상황을 막아 줍니다. 실제로 표본이 작은 선행연구일수록 보고된 효과크기가 과대평가되기 쉽다는 점은 메타분석 문헌에서 반복적으로 지적되어 왔습니다.
참고로 분산분석의 f와 에타제곱 사이에는 f = √(η² / (1 − η²)), 회귀의 f²와 R² 사이에는 f² = R² / (1 − R²)라는 관계가 있습니다. 선행연구가 η²나 R²만 보고했다면 이 식으로 변환해 넣으면 됩니다.
3단계 — 검정별 실습: 다섯 가지 사례
가장 자주 쓰이는 다섯 상황을 그대로 따라 할 수 있게 적어 두겠습니다. 모두 α = .05, 검정력 = .80, 양측 검정을 기준으로 합니다.
사례 1. 독립표본 t-검정 — 두 집단 평균 비교
- Test family: t tests
- Statistical test: Means: Difference between two independent means (two groups)
- Type of power analysis: A priori
- Tail(s): Two, Effect size d: 0.5, α err prob: 0.05, Power: 0.80, Allocation ratio N2/N1: 1
- Calculate 클릭
결과: Total sample size = 128, 각 집단 64명. 절차 자체는 SPSS 독립표본 t-검정 실전 튜토리얼과 짝을 이룹니다.
사례 2. 일원배치 분산분석 — 세 집단 비교
- Test family: F tests
- Statistical test: ANOVA: Fixed effects, omnibus, one-way
- Effect size f: 0.25, α: 0.05, Power: 0.80, Number of groups: 3
결과: Total sample size = 159, 집단당 53명. 집단 수로 나누어떨어지도록 맞춘 값입니다. 이후 분석 절차는 일원배치 분산분석과 사후검정 튜토리얼로 이어집니다.
사례 3. 다중회귀분석 — 예측변수 5개
- Test family: F tests
- Statistical test: Linear multiple regression: Fixed model, R² deviation from zero
- Effect size f²: 0.15, α: 0.05, Power: 0.80, Number of predictors: 5
결과: Total sample size = 92. 여기서 ‘예측변수 수’에는 통제변수도 포함됩니다. 성별·연령을 통제할 계획이라면 그 둘도 세어야 합니다. 특정 변수 하나의 고유 기여를 검정하려면 R² increase 옵션을 쓰며, 이는 SPSS 다중회귀분석 실전 튜토리얼에서 다루는 위계적 투입 상황에 해당합니다.
사례 4. 상관분석
- Test family: Exact
- Statistical test: Correlation: Bivariate normal model
- Correlation ρ H1: 0.30, α: 0.05, Power: 0.80, Correlation ρ H0: 0
결과: Total sample size = 84.
사례 5. 반복측정 분산분석에서 주의할 점
같은 사람을 여러 시점에 측정하는 설계라면 ANOVA: Repeated measures, within factors를 고릅니다. 여기서는 입력값이 두 개 더 늘어납니다. Number of measurements(측정 횟수)와 Corr among rep measures(반복측정 간 상관)입니다. 반복측정 간 상관을 얼마로 넣느냐에 따라 필요한 표본이 크게 달라지므로, 선행연구에서 사전·사후 점수의 상관을 찾아 넣거나 관례적으로 .50을 가정하고 그 사실을 밝히는 것이 안전합니다. 또 SPSS와 G*Power의 효과크기 정의가 다를 수 있어, 부분 에타제곱을 f로 변환할 때 <Determine> 창의 옵션을 확인해야 합니다.
한국어로 화면을 따라가며 표본 수를 산출하는 시연 영상도 있으니, 처음 켤 때 함께 보면 헤매는 시간이 줄어듭니다.
4단계 — 탈락률과 불성실 응답을 반영해 최종 목표를 정한다
G*Power가 준 숫자는 분석에 실제로 들어갈 사례 수입니다. 배포한 설문지 수가 아닙니다. 실제 모집 목표는 이렇게 계산합니다.
모집 목표 = 산출된 N ÷ (1 − 예상 탈락률)
예를 들어 사례 1의 128명에 불성실 응답과 결측 15%를 예상한다면 128 ÷ 0.85 = 150.6이므로 151명을 목표로 잡습니다. 종단연구나 중재연구라면 중도탈락률이 20~30%에 이르기도 하므로 보정 폭이 훨씬 커집니다.
보정률의 근거는 “대충 넉넉히”가 아니라 같은 방식으로 자료를 모은 선행연구의 회수율·탈락률에서 가져오는 것이 정석입니다. 그 숫자를 한 문장으로 밝혀 두면 계획서의 설득력이 눈에 띄게 올라갑니다.
5단계 — ‘사후 검정력’은 왜 문제가 되는가
자료를 다 모은 뒤 결과가 유의하지 않게 나오면, 많은 사람이 G*Power를 켜고 Post hoc으로 검정력을 구해 “검정력이 .42로 낮아 유의하지 않았다”고 쓰고 싶어집니다. 이 서술은 여러 방법론 문헌에서 비판받아 왔습니다.
이유는 이렇습니다. 관측된 자료의 효과크기를 그대로 넣어 계산한 사후 검정력은 유의확률의 다른 표현일 뿐입니다. p가 클수록 사후 검정력은 반드시 작게 나오므로, “검정력이 낮아서 유의하지 않았다”는 문장은 “유의하지 않아서 유의하지 않았다”는 동어반복이 됩니다. 새로운 정보가 하나도 없는 것입니다.
자료를 다 모은 뒤에 할 수 있는 정직한 대안은 셋입니다.
- Sensitivity 분석. “현재 표본 87명으로 검정력 .80에서 탐지 가능한 최소 효과크기는 d = 0.61이었다”처럼 씁니다. 우리 연구가 얼마나 작은 차이까지 볼 수 있었는지를 알려 주는 실질적 정보입니다.
- 신뢰구간 제시. 효과의 크기와 불확실성을 함께 보여 주므로 사후 검정력보다 훨씬 유용합니다.
- 한계 절에서의 정직한 서술. 표본이 작았다는 사실을 그대로 적고 후속 연구를 제언합니다.
6단계 — 연구방법 절에 넣을 서술 문장
계획서와 논문 모두에 들어가는 문단은 정해진 형태가 있습니다. 프로그램 이름과 버전, 검정 종류, 세 입력값과 그 근거, 산출된 N, 보정 후 목표를 한 문단에 담습니다.
사전 검정력 분석(계획서·논문 공통) — 본 연구에 필요한 표본 크기는 G*Power 3.1 프로그램을 이용하여 산출하였다. 독립표본 t-검정을 기준으로 유의수준 .05, 검정력 .80, 효과크기 d = .50을 적용한 결과 필요한 표본은 총 128명(집단당 64명)으로 나타났다. 효과크기는 동일한 프로그램을 적용한 선행연구에서 보고된 값을 참고하여 중간 수준으로 설정하였다. 여기에 탈락 및 불성실 응답률 15%를 고려하여 총 151명을 모집 목표로 하였다.
민감도 분석(자료 수집이 끝난 뒤) — 최종 분석에 포함된 표본은 118명이었다. 이 표본 크기에서 유의수준 .05, 검정력 .80으로 탐지 가능한 최소 효과크기는 d = .52로, 본 연구가 설정한 중간 수준의 효과를 검정하기에 충분한 것으로 판단되었다.
이 문단은 연구계획서 단계에서 이미 완성해 두는 것이 좋습니다. 계획서 전체의 구성은 연구계획서 작성법과 단계별 구성에 정리되어 있습니다.
계산은 끝났는데 문단이 안 써질 때
검정력 분석 문단은 숫자를 나열하기는 쉬워도, 근거와 판단이 자연스럽게 이어지는 학술 문체로 쓰기는 의외로 까다롭습니다. Tesify AI 학술 에디터로 연구방법 절의 문체와 연결어를 다듬으면 계획서 전체의 톤이 고르게 맞춰집니다. 효과크기를 어디서 가져올지, 탈락률을 얼마로 볼지 같은 판단은 연구자가 내리고, 문장을 정돈하는 작업만 맡기는 방식이 안전합니다.
심사와 IRB에서 자주 지적되는 실수
- 효과크기의 근거를 밝히지 않는 것. “중간 효과크기를 사용했다”만 적으면 “왜 중간입니까”를 묻습니다. 선행연구 인용이나 “근거가 부족하여 관례를 따랐다”는 한 문장이 필요합니다.
- 실제 분석과 다른 검정으로 계산하는 것. 최종 분석이 위계적 회귀인데 t-검정으로 표본 수를 산출했다면 근거가 성립하지 않습니다.
- 통제변수를 예측변수 수에서 빼먹는 것. 회귀에서 가장 흔한 누락입니다.
- 산출값보다 적게 모으고 넘어가는 것. 목표에 못 미쳤다면 그 사실과 그로 인한 한계를 적는 편이 훨씬 낫습니다.
- 사후 검정력으로 유의하지 않은 결과를 변명하는 것. 민감도 분석이나 신뢰구간으로 대체하십시오.
- IRB 심의서와 논문의 숫자가 다른 것. 표본 수를 중간에 바꿨다면 변경 심의가 필요할 수 있습니다. 인간 대상 연구의 심의 절차는 IRB 심의 완전 가이드에서 확인하십시오.
자주 묻는 질문
검정력을 .80이 아니라 .90으로 해야 하나요?
.80이 여전히 가장 널리 쓰이는 관례이지만, 의학·간호 분야나 중재효과 검증에서는 .90을 요구하기도 합니다. 소속 학과나 투고 예정 학술지의 최근 논문 몇 편이 어느 값을 썼는지 확인하는 것이 가장 확실합니다.
종속변수가 여러 개면 어떻게 하나요?
가장 핵심적인 가설, 또는 가장 큰 표본을 요구하는 검정을 기준으로 산출하는 것이 일반적입니다. 그렇게 하면 나머지 가설은 자동으로 충족됩니다. 어느 검정을 기준으로 삼았는지 밝히면 됩니다.
질적 연구에도 검정력 분석이 필요한가요?
아닙니다. 통계적 검정을 하지 않으므로 해당되지 않습니다. 질적 연구에서는 자료 포화(saturation) 도달을 표본 크기의 근거로 서술합니다.
G*Power가 실행되지 않거나 설치가 막힙니다.
무료 웹 기반 검정력 계산기나 R의 pwr 패키지로도 같은 계산을 할 수 있습니다. 다만 논문에는 실제로 사용한 도구와 버전을 정확히 적어야 합니다.
이미 자료를 다 모았는데 지금이라도 계산해야 하나요?
사전 검정력 분석을 소급해 “계획했다”고 쓰는 것은 사실과 다릅니다. 대신 Sensitivity 분석으로 “이 표본으로 탐지 가능한 최소 효과크기”를 제시하는 편이 정직하고, 심사에서도 더 좋은 평가를 받습니다.
정리
검정력 분석은 α·검정력·효과크기·표본 크기 네 값의 관계식을 푸는 일입니다. A priori 모드를 고르고(1단계), 효과크기를 선행연구에서 가져오고(2단계), 실제 쓸 검정에 맞는 설정으로 계산하고(3단계), 탈락률로 보정해 모집 목표를 정하고(4단계), 사후 검정력 대신 민감도 분석을 쓰고(5단계), 연구방법 절 문단으로 옮기면(6단계) 끝납니다. 이 계산을 자료 수집 전에 해 두면 계획서 심의와 논문 심사에서 같은 문단을 두 번 쓰게 됩니다.