“성별과 연령을 통제하고도 직무자율성이 조직몰입에 영향을 미치는가.” 이 문장이 논문의 가설이라면, 필요한 것은 일반 다중회귀가 아니라 위계적 회귀분석(hierarchical regression)입니다. 변수를 한꺼번에 넣지 않고 블록으로 나누어 순서대로 투입한 뒤, 각 블록이 추가로 설명하는 분산을 보는 방법입니다.
국내 사회과학 학위논문에서 가장 널리 쓰이는 회귀 형태이면서도, 결과표 만들기가 가장 까다로운 분석이기도 합니다. 이 글은 블록 설계부터 출력 판독, ΔR²와 ΔF 해석, 여러 모형을 한 표에 담는 조판 방법, 그리고 결과 서술 문장까지 순서대로 정리합니다. 회귀분석 자체가 처음이라면 SPSS 다중회귀분석 실전 튜토리얼을 먼저 보고 오시는 편이 빠릅니다.
위계적 회귀는 무엇이 다른가
일반 다중회귀에서는 모든 독립변수를 한 번에 넣고 각각의 고유 기여를 봅니다. 위계적 회귀는 여기에 순서를 더합니다. 1단계에 통제변수를 넣고 모형의 설명력을 확인한 뒤, 2단계에 관심 독립변수를 추가로 넣고 설명력이 얼마나 올랐는지를 봅니다. 그 증가분이 ΔR²(R 제곱 변화량)이고, 그 증가가 우연이 아닌지 판정하는 것이 ΔF입니다.
이 구조 덕분에 답할 수 있는 질문이 달라집니다.
- “인구통계 변수를 통제하고도 우리 변수가 의미가 있는가” — 논문에서 가장 자주 쓰이는 형태입니다.
- “조절효과가 있는가” — 마지막 단계에 상호작용항을 넣고 ΔR²가 유의한지를 봅니다.
- “어느 이론 블록이 더 큰 설명력을 갖는가” — 개인 요인 블록과 환경 요인 블록의 ΔR²를 비교합니다.
중요한 구분이 하나 있습니다. 위계적 회귀는 단계선택(stepwise)과 전혀 다릅니다. 단계선택은 통계 프로그램이 유의성에 따라 변수를 자동으로 넣고 뺍니다. 위계적 회귀는 연구자가 이론에 근거해 순서를 정합니다. 두 이름이 비슷해 혼동되지만, 심사에서 문제가 되는 것은 언제나 전자 쪽입니다.
이 글에서 계속 쓸 예시
직장인 241명을 대상으로 조직몰입을 종속변수로 하는 연구입니다. 통제변수는 성별·연령·근속연수, 관심 독립변수는 직무자율성과 상사지원, 그리고 마지막에 두 변수의 상호작용항을 넣습니다.
1단계 — 블록 설계: 순서가 곧 논리다
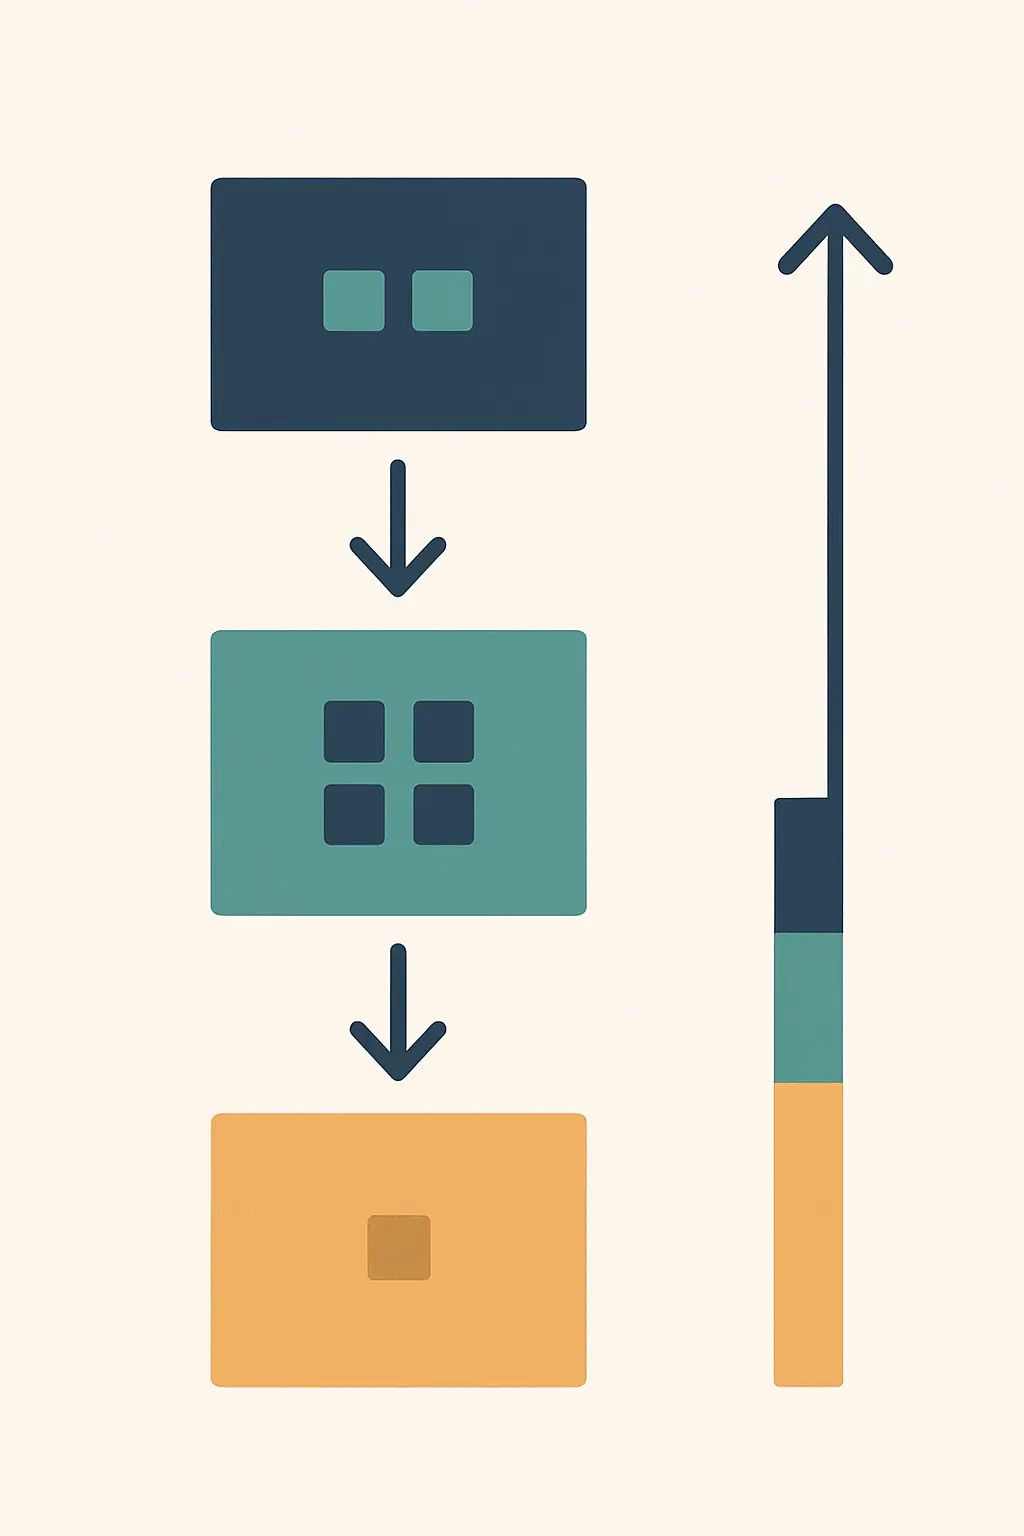
목표는 “왜 이 순서인가”에 답할 수 있는 설계를 만드는 것입니다. 널리 통용되는 원칙은 셋입니다.
- 통제변수를 먼저 넣는다. 성별·연령·학력·근속연수처럼 연구 관심사가 아니지만 종속변수에 영향을 줄 수 있는 변수들입니다. 이들을 먼저 넣어야 이후 단계의 ΔR²가 “통제 후의 순수 기여”가 됩니다.
- 인과적으로 앞선 변수를 먼저 넣는다. 시간적으로 앞서거나 이론적으로 선행하는 변수를 앞 블록에 둡니다.
- 상호작용항은 반드시 마지막에 넣는다. 그리고 상호작용항을 넣는 단계에는 그 항을 구성하는 주효과 변수들이 이미 모형에 들어 있어야 합니다. 이 순서를 어기면 상호작용 계수 자체가 해석 불가능해집니다.
흔한 실수는 “유의하게 나오는 순서”로 블록을 재배치하는 것입니다. 결과를 보고 순서를 바꾸면 그 순간 확인적 검정이 아니라 탐색이 되고, 심사에서 되돌리기 어려운 지적을 받습니다. 어떤 변수가 통제변수이고 어떤 변수가 관심 변수인지가 흔들린다면 독립·종속·매개·조절·통제변수 구분과 조작적 정의로 돌아가 변수표부터 확정하십시오.
통제변수를 고르는 기준
“일단 넣고 보자”는 태도가 가장 위험합니다. 통제변수를 늘릴수록 자유도가 줄고 검정력이 떨어지며, 종속변수와 무관한 변수는 ΔR²만 갉아먹습니다. 넣을 근거는 둘 중 하나여야 합니다. 선행연구에서 그 변수가 종속변수와 관련된다고 반복적으로 보고되었거나, 이론적으로 교란 가능성이 분명하거나입니다. 범주형 통제변수는 반드시 더미변수로 바꾸어 넣고, 범주가 k개면 더미는 k − 1개만 만듭니다.
범주형 통제변수를 더미변수로 바꾸는 실제 절차
성별·전공계열·고용형태처럼 범주형 변수를 통제하려면 그대로 넣을 수 없습니다. <변환 → 다른 변수로 코딩변경>에서 새 변수를 만들거나, <변환 → 변수 계산>에서 조건식으로 0과 1을 부여합니다. 예를 들어 성별을 남성 1, 여성 2로 코딩해 두었다면 ‘성별더미 = (성별 = 2)’로 계산해 여성이 1, 남성이 0인 변수를 만듭니다. 이때 0이 되는 쪽이 기준집단이고, 회귀계수는 “기준집단 대비 차이”로 읽힙니다.
범주가 셋 이상이면 더미는 범주 수 − 1개를 만듭니다. 전공계열이 인문·사회·이공 셋이라면 더미는 두 개(사회더미, 이공더미)이고 인문계열이 기준집단이 됩니다. 세 개를 다 만들어 넣으면 완전공선성이 생겨 SPSS가 변수 하나를 조용히 제외해 버립니다. 그리고 같은 범주에서 나온 더미들은 반드시 같은 블록에 함께 투입해야 합니다. 사회더미만 1단계에 넣고 이공더미를 2단계에 넣으면 ΔR²가 ‘전공의 효과’를 뜻하지 않게 됩니다. 논문 표에는 기준집단이 무엇인지를 변수명 옆에 괄호로 밝혀 두는 것이 관례입니다.
2단계 — 클릭 순서
일반 회귀와 메뉴는 같습니다. 다른 것은 <다음(Next)> 버튼 하나뿐입니다.
- 분석(Analyze) → 회귀분석(Regression) → 선형(Linear)을 클릭합니다.
- 조직몰입을 종속변수 칸으로 옮깁니다.
- 독립변수 칸에 1단계 변수(성별더미, 연령, 근속연수)를 넣습니다. 이때 칸 위쪽에 “블록 1/1”이라고 표시되어 있는지 확인합니다.
- <다음(Next)> 버튼을 누릅니다. 표시가 “블록 2/2”로 바뀌고 칸이 비워집니다. 여기서 앞 단계 변수를 다시 넣으면 안 됩니다 — SPSS가 누적해서 계산합니다.
- 비워진 칸에 2단계 변수(직무자율성, 상사지원)를 넣습니다.
- 다시 <다음>을 누르고 3단계 변수(상호작용항)를 넣습니다.
- 통계량(Statistics)에서 추정값, 모형 적합, R 제곱 변화량, 공선성 진단, Durbin-Watson을 체크합니다. R 제곱 변화량을 체크하지 않으면 이 분석의 핵심 숫자가 아예 출력되지 않습니다.
- 방법(Method)은 모든 블록에서 입력(Enter)으로 둡니다.
- 확인(OK)을 누릅니다.
상호작용항은 미리 만들어 두어야 합니다. <변환 → 변수 계산>에서 평균중심화한 두 변수를 곱해 새 변수를 생성합니다. 중심화가 실제로 무엇을 해결하고 무엇을 해결하지 않는지는 다중공선성(VIF) 진단과 해결에서 자세히 다뤘습니다.
메뉴 흐름을 한국어로 시연한 영상이 있으니 화면을 대조해 보십시오.
3단계 — 출력 읽기: 모형 요약 표가 주인공이다
일반 회귀에서는 계수표가 주인공이지만, 위계적 회귀에서는 모형 요약 표가 주인공입니다. 여기에 R 제곱 변화량, F 변화량, 자유도 1·2, 유의확률 F 변화량 열이 붙어 있습니다.
읽는 순서는 이렇습니다.
- 각 모형의 R²와 수정된 R²를 확인해 설명력이 단계마다 어떻게 쌓이는지 봅니다.
- ΔR²가 각 단계가 추가로 설명한 몫입니다. 2단계의 ΔR² = .244라면 “통제변수를 통제한 뒤에도 두 독립변수가 조직몰입 변량의 24.4%를 추가로 설명했다”는 뜻입니다.
- ΔF와 유의확률 F 변화량이 그 증가의 유의성을 판정합니다. 이 값이 유의해야 그 블록을 넣은 것이 정당화됩니다. ΔR²가 커 보여도 ΔF가 유의하지 않으면 “유의한 증가는 없었다”가 결론입니다.
- 계수표에서는 각 모형별로 β가 따로 나옵니다. 최종 모형의 β만 보고하지 말고 단계별 변화도 함께 보십시오. 2단계에서 유의했던 통제변수가 3단계에서 사라진다면 그 자체가 해석거리입니다.
예시 결과. 1단계 R² = .068(F(3, 237) = 5.76, p = .001), 2단계 R² = .312로 ΔR² = .244(ΔF(2, 235) = 41.67, p < .001), 3단계 R² = .334로 ΔR² = .022(ΔF(1, 234) = 7.73, p = .006)였습니다.
여기서 눈여겨볼 것이 3단계입니다. ΔR²가 .022로 작아 보이지만 유의합니다. 상호작용항의 ΔR²는 원래 작게 나오는 것이 정상이며, 사회과학 문헌에서 조절효과의 설명량이 1~3% 수준으로 보고되는 일은 흔합니다. 크기가 작다는 이유로 “조절효과가 없다”고 쓰면 안 됩니다.
조절효과가 확인되면 반드시 해야 할 일
상호작용항이 유의하다고 해서 끝이 아닙니다. 어느 방향으로 조절하는지를 보여 주어야 합니다. 표준적인 방법은 조절변수를 평균 ± 1 표준편차 수준으로 나눈 뒤 각 수준에서의 기울기를 그리는 단순기울기 분석입니다.
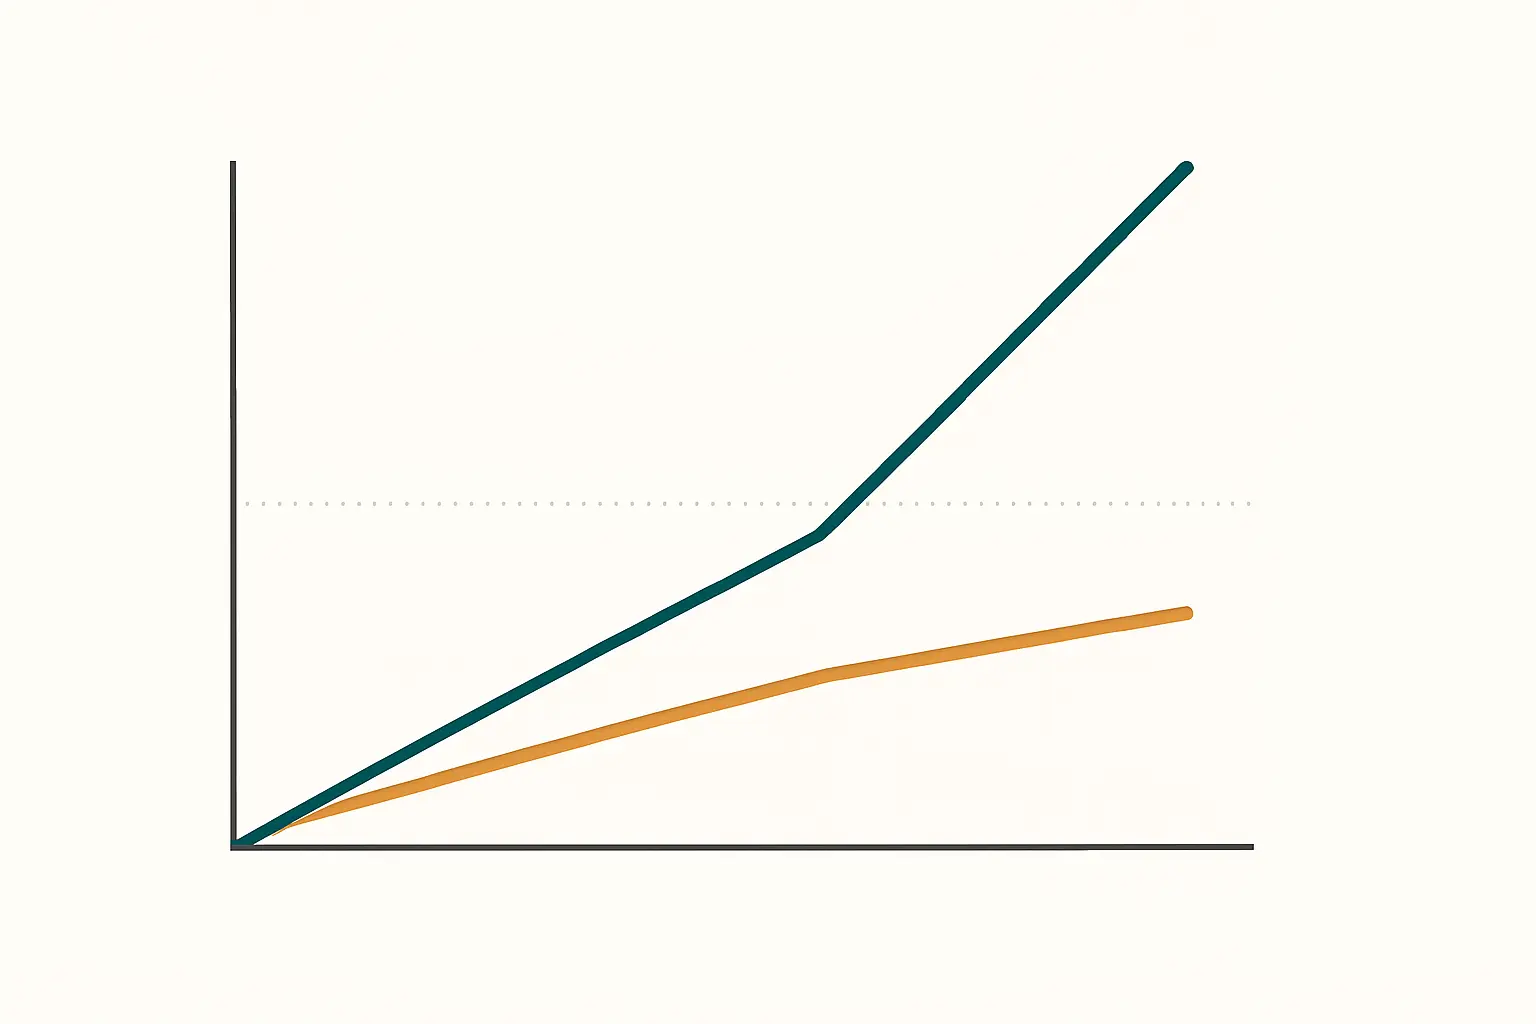
SPSS 기본 메뉴에는 이 기능이 없어 PROCESS 매크로를 설치해 쓰는 경우가 많습니다. 절차 전체는 매개효과·조절효과 분석과 PROCESS 매크로·부트스트랩에 정리되어 있습니다.
4단계 — 여러 모형을 한 표에 담는 법
위계적 회귀표는 모형 수만큼 열이 늘어나는 구조입니다. 각 모형의 β를 나란히 두고, 표 아래쪽에 R²·ΔR²·ΔF를 모아 붙입니다.
| 변수 | 모형 1 β | 모형 2 β | 모형 3 β |
|---|---|---|---|
| 성별(여성 = 1) | .09 | .05 | .04 |
| 연령 | .18* | .12* | .11 |
| 근속연수 | .14* | .10 | .09 |
| 직무자율성 | — | .39*** | .38*** |
| 상사지원 | — | .30*** | .29*** |
| 직무자율성 × 상사지원 | — | — | .16** |
| R² | .068 | .312 | .334 |
| 수정된 R² | .056 | .297 | .317 |
| ΔR² | .068 | .244 | .022 |
| ΔF | 5.76** | 41.67*** | 7.73** |
주. * p < .05, ** p < .01, *** p < .001. 상호작용항은 평균중심화한 변수로 산출하였다. 모형 3의 F(6, 234) = 19.56, p < .001.
표를 만들 때 지켜야 할 것이 셋 있습니다. 첫째, 모든 모형의 계수를 다 싣습니다. 최종 모형만 남기면 ΔR²의 의미가 사라집니다. 둘째, ΔF의 자유도는 표 아래 주나 별도 열에 밝힙니다. 셋째, 변수 이름의 순서를 블록 순서와 일치시킵니다. 표 전체의 캡션과 주석 규칙은 결과 절 서술과 함께 논문 연구 결과(Results) 작성법에서 확인하실 수 있습니다.
단계별 계수 변화를 읽는 법
표에서 가장 많은 정보를 담고 있으면서도 가장 자주 지나쳐지는 부분이 같은 변수의 β가 모형을 넘어가며 어떻게 변하는가입니다. 예시 표에서 근속연수는 모형 1에서 유의했지만(β = .14) 모형 2에서 유의성을 잃습니다(β = .10). 이것은 오류가 아니라 발견입니다. 근속연수가 조직몰입과 갖던 관계의 상당 부분이 사실은 직무자율성과 상사지원을 통해 설명되는 부분이었다는 뜻이기 때문입니다.
이런 변화는 고찰에서 한 문단을 얻을 수 있는 재료입니다. “근속연수의 효과가 직무 특성 변수 투입 후 사라졌다는 것은, 오래 근무한 사람이 몰입도가 높은 것이 아니라 오래 근무한 사람일수록 자율성과 지지를 더 많이 확보하고 있기 때문일 가능성을 시사한다”처럼 씁니다. 다만 이 서술은 매개를 검증한 것이 아니라 가능성을 제기하는 수준이라는 점을 문장 안에 담아야 합니다. 계수가 줄었다는 사실만으로 매개를 주장하면 근거 없는 확대 해석이 됩니다.
5단계 — 결과 서술 문장 템플릿
단계마다 한 문장씩, 그리고 마지막에 판정 문장을 붙입니다. 핵심은 ΔR²를 반드시 문장에 넣는 것입니다. 그것이 이 분석을 쓴 이유이기 때문입니다.
① 분석 진술 — 인구통계학적 변수를 통제한 상태에서 직무자율성과 상사지원이 조직몰입에 미치는 영향과 두 변수의 상호작용 효과를 검증하기 위해 위계적 회귀분석을 실시하였다. 1단계에는 성별, 연령, 근속연수를, 2단계에는 직무자율성과 상사지원을, 3단계에는 두 변수의 상호작용항을 투입하였다.
② 가정 점검 — 분석에 앞서 Durbin-Watson 값은 1.94로 잔차의 독립성 가정을 충족하였고, 모든 변수의 분산팽창지수(VIF)는 1.21~2.08로 기준치 10을 밑돌아 다중공선성 문제는 없는 것으로 판단하였다.
③ 1단계 — 통제변수만 투입한 모형 1은 조직몰입 변량의 6.8%를 설명하였으며 통계적으로 유의하였다(F(3, 237) = 5.76, p < .01).
④ 2단계 — 직무자율성과 상사지원을 추가로 투입한 결과 설명력이 24.4%포인트 증가하여 통계적으로 유의한 변화를 보였다(ΔR² = .244, ΔF(2, 235) = 41.67, p < .001). 두 변수는 모두 조직몰입에 유의한 정적 영향을 미쳤으며, 직무자율성(β = .39, p < .001)이 상사지원(β = .30, p < .001)보다 상대적으로 큰 영향력을 보였다.
⑤ 3단계 — 상호작용항을 투입한 모형 3에서도 설명력이 유의하게 증가하여(ΔR² = .022, ΔF(1, 234) = 7.73, p < .01), 상사지원이 직무자율성과 조직몰입의 관계를 조절하는 것으로 나타났다(β = .16, p < .01).
⑥ 판정 — 따라서 가설 1과 가설 2는 지지되었으며, 조절효과를 예측한 가설 3도 지지되었다.
“24.4%포인트 증가”라는 표현에 주목하십시오. 설명력의 증가분은 비율의 차이이므로 ‘퍼센트포인트’로 적는 것이 정확합니다. 사소해 보여도 꼼꼼한 심사위원은 이런 표기를 봅니다.
모형이 셋인데 문단도 셋, 표현도 똑같아질 때
위계적 회귀 서술은 “~을 추가로 투입한 결과 설명력이 유의하게 증가하였다”가 단계마다 반복되는 구조입니다. 종속변수가 여러 개인 논문이라면 같은 문형이 열 번 넘게 나옵니다. Tesify AI 학술 에디터로 단계별 문단의 연결어와 문체를 정돈하면 같은 정보를 훨씬 매끄럽게 이어 붙일 수 있습니다. 블록 순서를 어떻게 정할지, ΔR²의 크기를 어떻게 평가할지 같은 판단은 연구자 몫으로 남겨 두는 방식이 안전합니다.
심사에서 자주 지적되는 실수 여섯 가지
- 블록 순서의 근거를 밝히지 않는 것. “선행연구에 근거하여” 한 구절이면 방어가 됩니다.
- ΔR²를 보고하지 않는 것. 그것 없이는 위계적 회귀를 쓴 이유가 사라집니다. R 제곱 변화량 옵션을 켜지 않아 아예 값이 없는 경우도 흔합니다.
- ΔF의 자유도를 빼먹는 것. F 값은 자유도 없이 해석되지 않습니다.
- 최종 모형만 표에 싣는 것. 단계별 계수 변화가 이 분석의 정보입니다.
- <다음> 대신 변수를 누적해서 다시 넣는 것. 블록이 뒤엉켜 ΔR²가 이상하게 나옵니다.
- 단계선택(stepwise)으로 돌려 놓고 ‘위계적’이라 적는 것. 완전히 다른 방법입니다. 방법 칸이 입력(Enter)인지 반드시 확인하십시오.
자주 묻는 질문
ΔR²가 .02인데 너무 작은 것 아닌가요?
유의하다면 작지 않습니다. 특히 상호작용항의 ΔR²는 1~3% 수준으로 보고되는 경우가 흔합니다. 크기는 ‘작지만 유의한 증가’로 있는 그대로 서술하고, 실질적 의미는 고찰에서 논하십시오.
통제변수가 하나도 유의하지 않으면 빼도 되나요?
이론적 근거로 넣었다면 유의하지 않아도 유지하는 것이 원칙입니다. 유의성을 보고 빼는 것은 사후 조정입니다. 다만 통제변수가 지나치게 많고 표본이 작다면 처음부터 설계를 다시 검토해야 합니다.
블록이 네 개 이상이어도 되나요?
가능하지만 블록이 늘수록 표가 커지고 자유도가 줄어듭니다. 실무적으로는 세 블록 안팎이 가장 읽기 좋습니다.
2단계에서 유의했던 변수가 3단계에서 유의하지 않게 됐습니다.
새로 들어온 변수와 겹치는 설명량이 있다는 뜻입니다. 상관행렬과 VIF를 함께 확인하고, 변수 간 관계는 상관분석 결과를 근거로 고찰에서 해석하십시오.
매개효과도 위계적 회귀로 검증할 수 있나요?
Baron과 Kenny 방식의 단계적 회귀로 검증하던 관행이 있었지만, 최근에는 부트스트랩 기반의 간접효과 검정이 표준으로 자리 잡았습니다. 매개는 위계적 회귀보다 전용 절차를 쓰는 편이 낫습니다.
정리
이론에 근거해 블록 순서를 정하고(1단계), 선형회귀 대화상자에서 <다음> 버튼으로 블록을 나누며 R 제곱 변화량 옵션을 반드시 켜고(2단계), 모형 요약 표에서 ΔR²와 ΔF를 읽고(3단계), 모든 모형의 계수를 한 표에 담은 뒤(4단계), 단계마다 한 문장씩 ΔR²를 넣어 서술하면(5단계) 끝납니다. 위계적 회귀의 힘은 계수 하나가 아니라 단계 사이의 변화에 있다는 점만 기억하면, 표와 문장이 자연히 정리됩니다.